 My CV
论文笔记:CoTJudger 如何衡量大模型推理中的冗余?
论文标题:CoTJudger: A Graph-Driven Framework for Automatic Evaluation of Chain-of-Thought Efficiency and Redundancy in LRMs
论文地址:https://arxiv.org/abs/2603.07078
项目地址:https://github.com/41ForOne/CoTJudger
作者单位:University of Science and Technology of China;ByteDance SEED;Shenzhen University of Advanced Technology;Shenzhen Institutes of Advanced Technology, CAS;Southeast University;UNSW Sydney;Nanjing University;Beihang University;University of Manchester
时间:2026 年 3 月 7 日
一句话概括
这篇论文想解决一个越来越现实的问题:大推理模型的 Chain-of-Thought 越写越长,但长出来的部分到底是在真正推理,还是只是在绕圈、自我确认、重复解释?作者提出 CoTJudger,把自由文本形式的 CoT 转成有向依赖图,再抽出从题目到正确答案所需的 Shortest Effective Path, SEP,用它来衡量哪些推理步骤是必要的,哪些是结构性冗余。
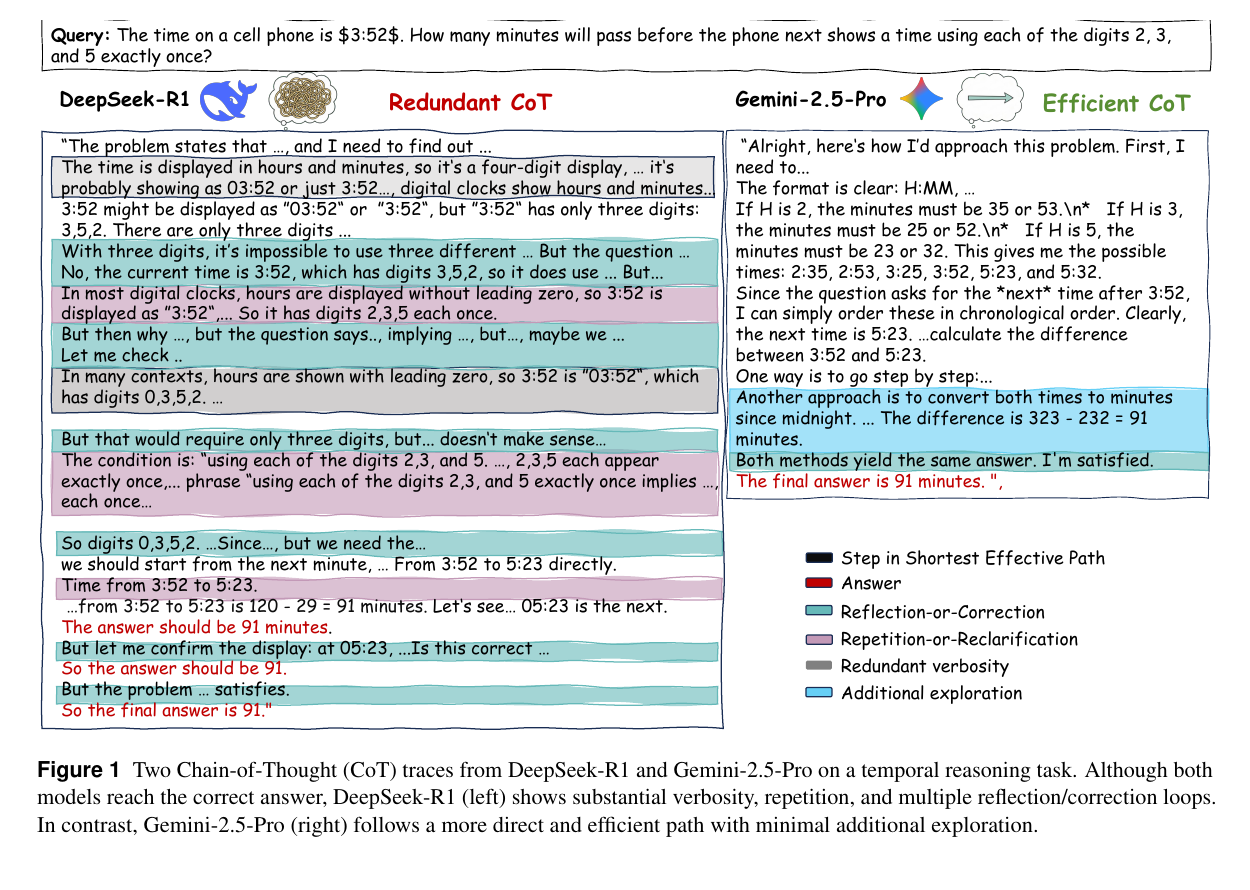
上图是论文的核心直觉:DeepSeek-R1 和 Gemini-2.5-Pro 都答对了同一道题,但左边的 CoT 包含大量重复、反思、纠错和绕路;右边则更直接。传统评价指标看到的可能只是“都答对了”或者“左边 token 更多”,但 CoTJudger 试图进一步回答:这些 token 里,哪些是真的必要步骤?
1. 问题:只看正确率和 token 数不够
Large Reasoning Models, LRMs 通过生成较长的 CoT 来提升复杂任务上的表现。问题是,长 CoT 带来了更高推理成本,也引入了 over-reasoning:
- 重复澄清已经清楚的问题;
- 在错误路径附近来回打转;
- 答案已经出现后继续验证;
- 为了“显得在推理”生成大量无效内容;
- 在不确定时扩大搜索,但不一定提升最终正确率。
已有方法通常用两类指标评价 CoT:
- 最终答案是否正确:能衡量任务表现,但看不到推理过程是否浪费。
- token 数或长度:能衡量成本,但无法区分必要复杂度和无意义冗余。
比如一道题本身很难,模型需要长推理是合理的;另一道题很简单,模型却生成几千 token 反复确认,这才是冗余。单纯的 token 长度无法区分这两种情况。
所以论文的核心问题可以写成:
如果一个 CoT 最终答对了,我们能否自动找出“足以推出答案的最短有效推理路径”,并据此度量剩余内容的冗余程度?
2. 动机:从线性文本转向图结构
CoT 表面上是一段线性文本,但推理过程并不总是线性的。模型可能:
- 从某一步回头检查前面的假设;
- 推翻一个中间结论;
- 另起一个解法分支;
- 对同一内容做语义重复;
- 已经给出答案后继续生成。
如果只把 CoT 看成句子序列,很难表示这些“回跳”“修正”“重复”和“旁支”。作者因此把 CoT 转成有向图:
\[G = (V, E)\]其中,节点 $V$ 是原子化(原文用词为atomization,这里可以引申为一个推理思考步骤的最小单元)后的推理步骤,边 $E$ 表示步骤之间的逻辑依赖、顺序推进、回溯、重复或跳转。这样一来,冗余不再只是“字数多”,而变成了图上的结构:哪些节点被最短有效路径使用,哪些节点只是绕路、重复或无效分支。
3. 创新点:CoTJudger 做了什么
我理解这篇论文的创新主要有四点。
第一,把 CoT 冗余定义为结构冗余。
论文不是简单地惩罚长 CoT,而是用 SEP 判断“哪些步骤对推出正确答案是必要的”。这比 token-level 评价更接近推理本身。
第二,提出 Shortest Effective Path。
SEP 是从虚拟起点到正确答案节点的最短、逻辑自洽路径。它不是任意最短路径,而是需要通过验证:仅凭这条路径上的步骤,是否足以严谨推出最终答案。
第三,构建功能节点分类体系。
作者把 CoT 中的原子步骤标注为不同功能类型,例如 Problem-Deconstruction、Intermediate-Inference、Reflection-or-Verification、Correction-or-Refinement、Additional-Exploration、Repetition-or-Reclarification、Irrelevant-or-Redundant 等。这样可以知道冗余来自哪里:是反复验证,是重复解释,还是错误修正。
第四,用图拓扑指标诊断模型的推理病灶。
例如平均度、最大入度、最大出度、自环比例、后向边比例等。它们可以揭示不同模型的冗余形态:有的模型是局部反复回跳,有的模型是全局啰嗦,有的模型是在答案后继续验证。
4. 方法:CoTJudger 的六步流程
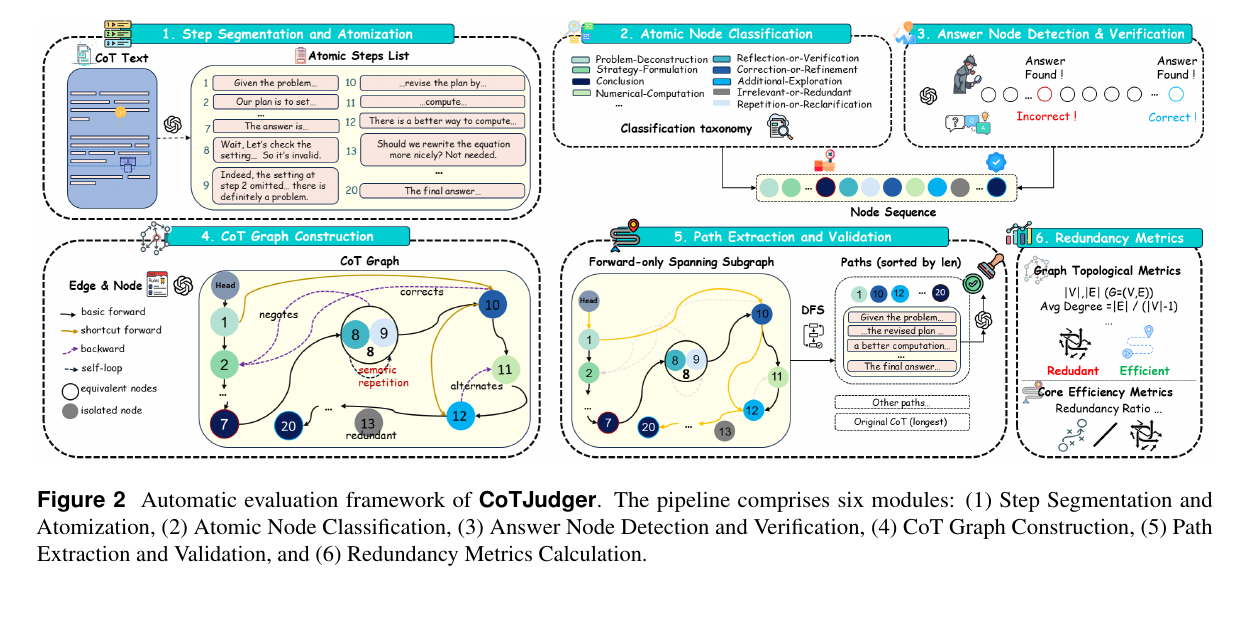
CoTJudger 的整体流程分成六个模块。
4.1 Step Segmentation and Atomization
首先把原始 CoT 切成初始片段:
\[S = [s_1, s_2, \ldots, s_k]\]论文先用换行、双换行等启发式分隔符做粗切分,同时保护代码块,避免程序题中的代码被切坏。随后用 GPT-5 做 atomization:合并过碎的片段,拆分包含多个推理动作的片段,得到最终节点:
\[V = \{N_1, N_2, \ldots, N_n\}\]这里有一个细节值得注意:模型不是重写原文,而是输出 index-level 的结构编辑,减少改写带来的语义噪声。 作者不希望 GPT-5 直接重写 CoT,因为一旦重写,就可能改变原意。比如模型原来写得很啰嗦、犹豫、错误,如果 GPT-5 把它润色了,后面的冗余分析就不真实了。
所以它不是让 GPT-5 输出新文本,而是让它输出类似:
Merge steps 3-4.
Split step 7 into two parts.
Keep step 8 unchanged.
这叫 index-level structural edits:只改结构,不改内容。论文说这样可以减少 paraphrasing noise。
4.2 Atomic Node Classification
接着给每个节点分配功能标签。论文使用一个跨领域的两层 taxonomy,覆盖数学、通用推理、编程、物理化学生物等任务。
这一步的重点不是看表面词。例如一句话看起来像“让我检查一下”,未必就是真正的验证节点;它可能实际承担的是中间推理功能。因此分类时需要结合全局推理上下文。
4.3 Answer Node Detection and Verification
很多 CoT 并不是最后一句才给答案。模型可能中途已经说出正确答案,后面又继续检查;也可能先给错答案,再修正;还可能出现多个候选答案。
因此 CoTJudger 会检测所有包含结论的节点,并用领域相关协议验证答案:
- 数学、通用推理、PCB 等任务,用逻辑一致性和标准答案核验;
- 编程任务,则在隔离环境中执行代码来验证。
这一步很关键,因为后面抽 SEP 时,终点必须是“被验证为正确的答案节点”。
4.4 CoT Graph Construction
图构建是整篇论文最核心的部分。作者引入一个虚拟头节点 $N_{root}$ 作为统一起点,然后根据节点类型构造不同边。
主要边类型包括:
- Basic Forward edge:默认顺序边,从 $N_i$ 指向 $N_{i+1}$。
- Self-loop:如果两个节点语义重复,给重复节点添加自环或等价标识,表示 repetition。
- Backward edge:用于表示反思、验证、修正、回跳。
- Shortcut Forward edge:当某些节点被确认是辅助验证或无效路径时,添加跳过它们的捷径边。
直觉上,普通 CoT 是一条线;CoTJudger 把它变成带有回路、分支和捷径的图。冗余越多,图结构通常越复杂。
4.5 Path Extraction and Validation
给定图 $G$ 和正确答案节点 $N_{ans}$,CoTJudger 先保留 forward 与 shortcut 边,得到一个 forward-only 子图 $G_{forward}$。然后用 DFS 枚举从 $N_{root}$ 到 $N_{ans}$ 的候选路径,并按节点数从短到长排序。
候选路径还要经过 LLM 验证:把路径上的节点文本拼起来,判断它是否足以推出答案。第一个通过验证的路径就是 SEP。
可以把 SEP 理解为:这段 CoT 真正需要保留下来的最短推理骨架。
4.6 Redundancy Metrics Calculation
论文定义了三类指标。
基础统计指标:
\[tokens,\quad acc\]分别表示 CoT token 数和最终准确率。
图拓扑指标:
节点数和边数:
\[|V|,\quad |E|\]平均度:
\[\bar{D} = \frac{|E|}{|V|-1}\]| 论文把 $\bar{D}$ 看作图的结构负担。理想情况下,一条完全线性的有效 CoT 有 $ | E | = | V | -1$,因此 $\bar{D}$ 接近 1;如果出现大量回跳、重复、捷径和复杂依赖,$\bar{D}$ 会变大。 |
核心效率指标:
SEP 长度:
\[L_{eff}\]冗余率:
\[R = \frac{|V| - L_{eff}}{|V|}\]这个公式是整篇论文最重要的指标之一。$R$ 越高,说明 CoT 中越多节点不在最短有效路径上。
不确定率:
\[U\]论文用它描述包含多个候选答案节点的比例,反映模型在推理中是否摇摆。
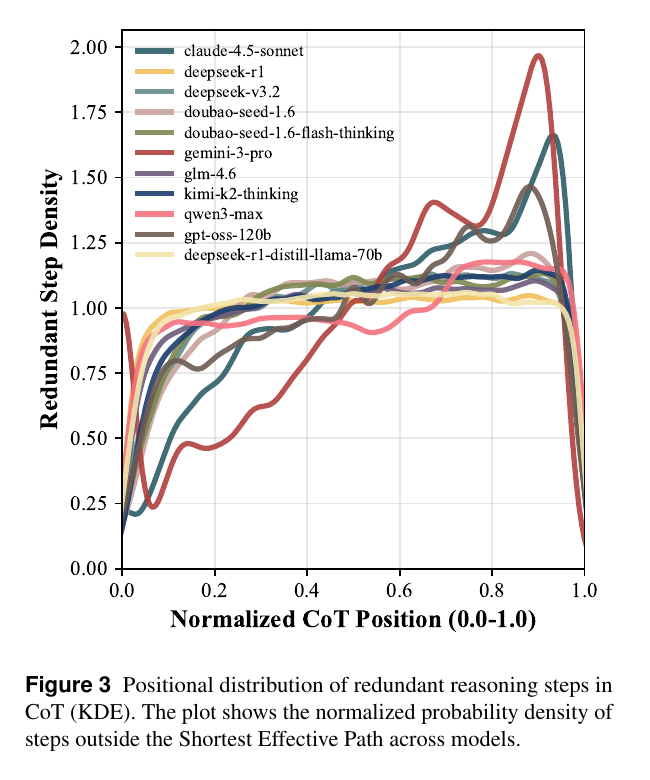
Figure 3 展示了冗余步骤在 CoT 位置上的分布。一个有意思的发现是:冗余并不是均匀出现的。多数模型在开头较少冗余,中段进入平台,接近答案前明显上升。这说明很多模型会在快给答案时集中自检、总结和确认。
5. 实验:21 个 LRM 的大规模对比
论文在 896 个 query 上测试了 21 个代表性 LRM,覆盖四个领域:
- Math:364 个;
- General Reasoning:270 个;
- Programming:164 个;
- PCB:98 个。
模型包括 proprietary、open-source 和 distilled 三类,例如 Claude-Sonnet-4.5、Gemini 系列、Doubao 系列、Qwen3-Max、DeepSeek 系列、GLM-4.6、Kimi-K2-Thinking、gpt-oss 系列,以及多个 DeepSeek-R1 distillation 版本。
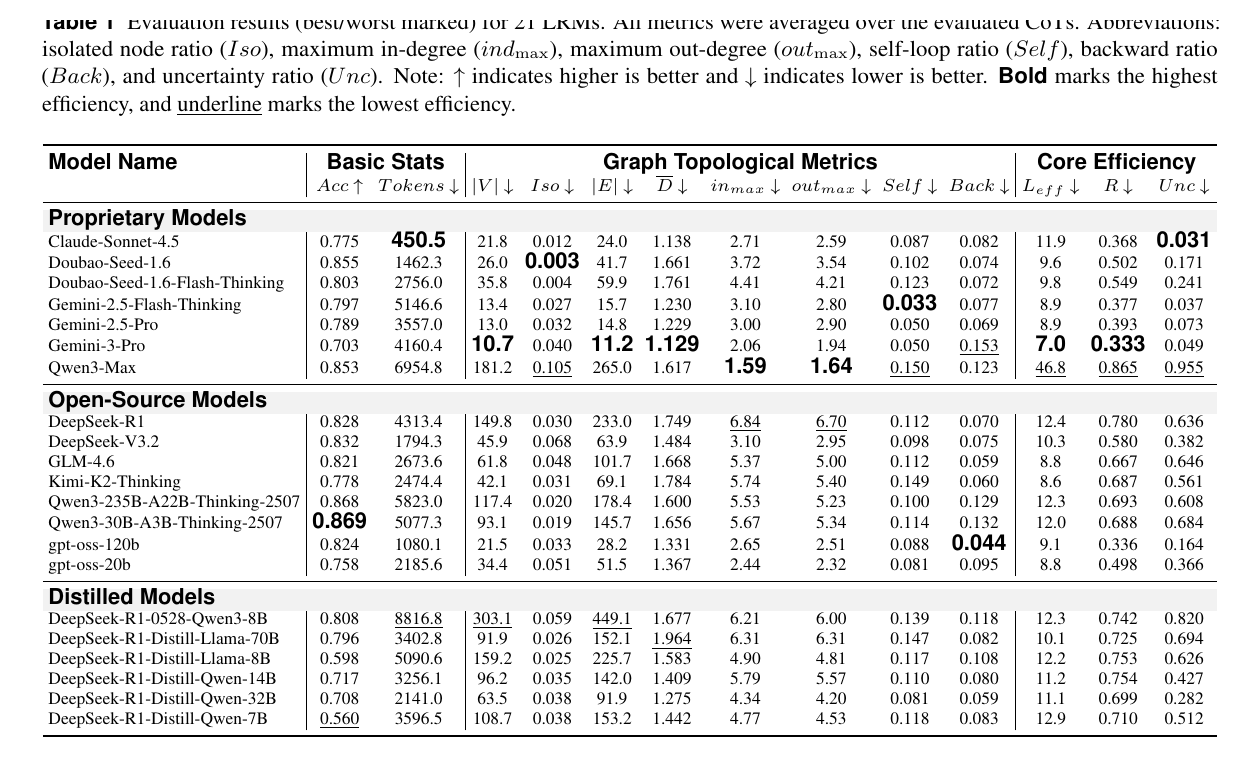
几个结果特别值得记。
5.1 正确率高不等于推理高效
Qwen3-Max 准确率达到 0.853,但平均节点数高达 181.2,冗余率 $R = 0.865$。这意味着在图结构意义上,它大量计算预算花在非必要步骤上。
相对地,gpt-oss-120b 准确率超过 0.8,同时保持较低冗余,论文认为它接近 Pareto frontier:正确率和效率之间取得了更好的平衡。
5.2 有些模型是在用 verbosity 补偿能力
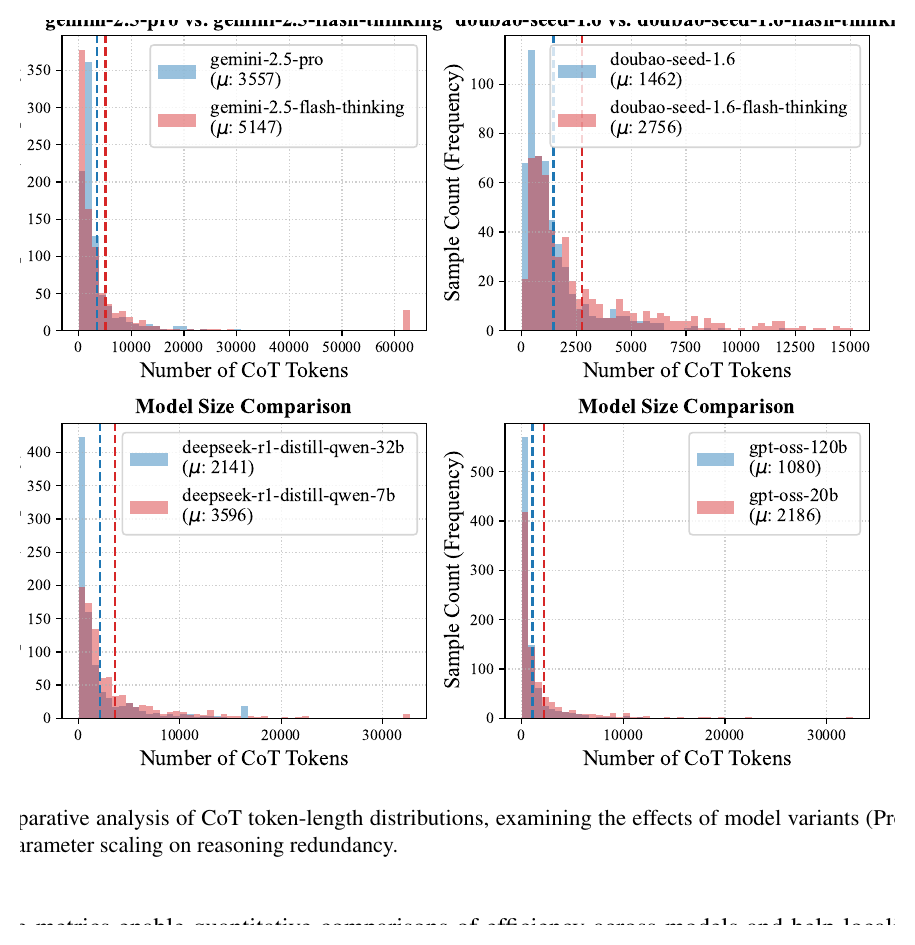
Figure 4 比较了不同模型版本和参数规模下的 CoT token 分布。Flash 或小参数模型往往分布右移、长尾更明显。论文将其解释为一种 test-time scaling:模型用更多 token 弥补单步推理能力不足。
但这种补偿并不稳定。Gemini-2.5-Flash-Thinking 出现超过 60,000 token 的极端样本,说明停止机制在边界情况下可能失效。
5.3 不同领域有共同骨架,也有领域差异
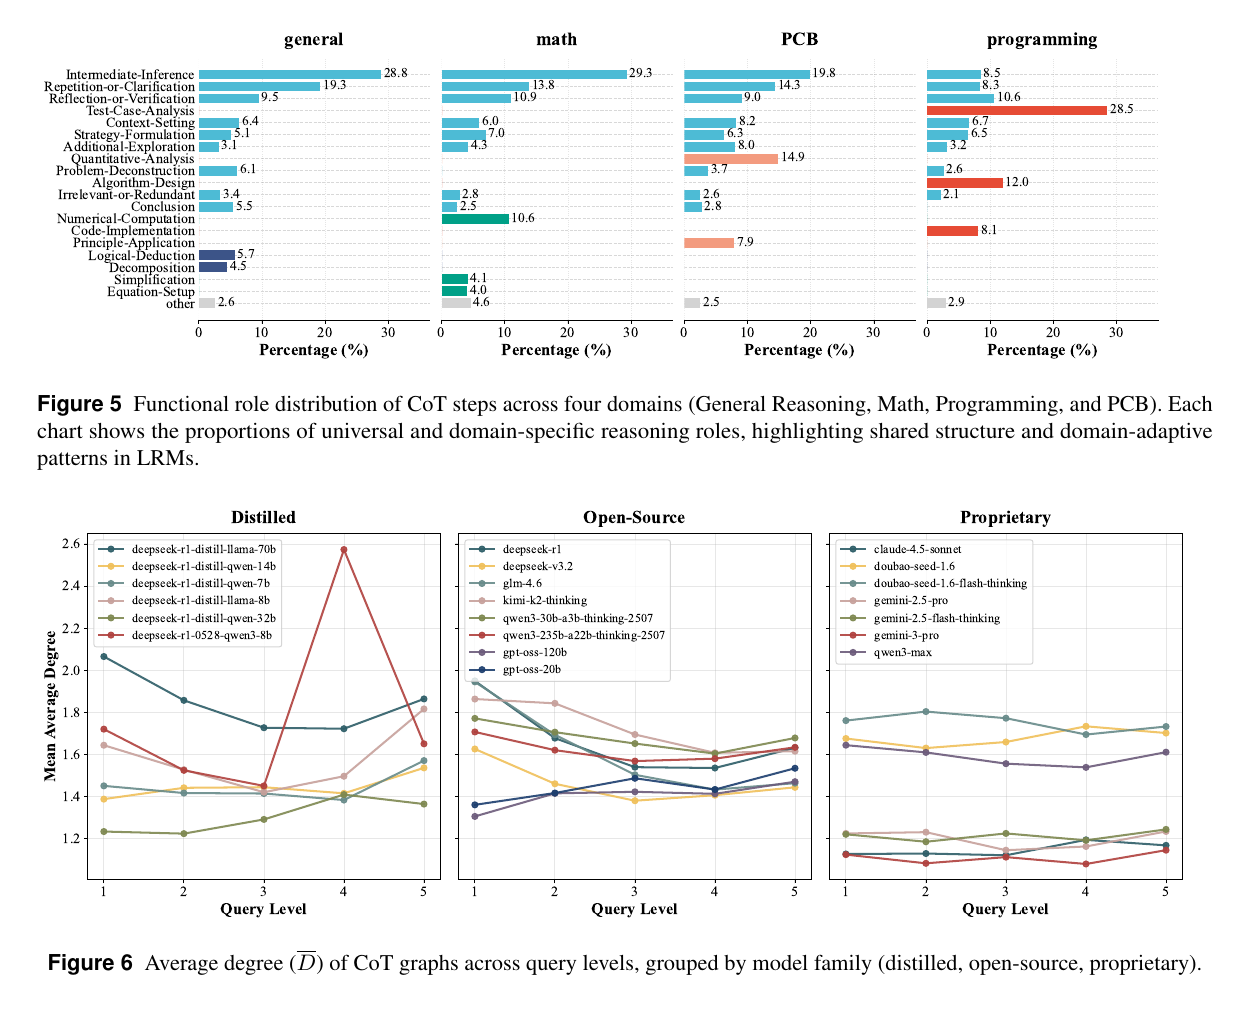
Figure 5 表明,不同领域的 CoT 有共同的推理骨架:Intermediate-Inference 和 Reflection-or-Verification 在多个领域都占重要比例。与此同时,不同领域也有明显差异:
- 数学更强调数值计算、公式建立和化简;
- PCB 更强调原则应用和定量分析;
- 编程中 Test-Case-Analysis 占比很高,达到 28.5%,说明程序推理更偏向结果驱动的验证逻辑。
Figure 6 则展示了难度变化下图平均度 $\bar{D}$ 的变化。proprietary 模型整体更稳定,推理结构接近线性;open-source 模型呈现 U 型趋势:简单题也容易 over-reasoning,中等难度时效率较好,太难时又进入回溯和绕圈;distilled 模型在某些难度上会出现明显结构崩塌。
5.4 答案之后的推理未必有用
论文还研究了 external redundancy,即模型第一次给出答案之后继续生成的内容。作者把答案转移分成四类:
- Destructive Revision, DR:正确到错误。模型本来答对了,继续想,反而改错。
- Superfluous Verification, SV:正确到正确。答案没变,但继续做无效确认。
- Error Entrenchment, EE:错误到错误。在错误里越绕越深。
- Effective Backwards, EB:错误到正确。虽然绕了,但最终修正成功。
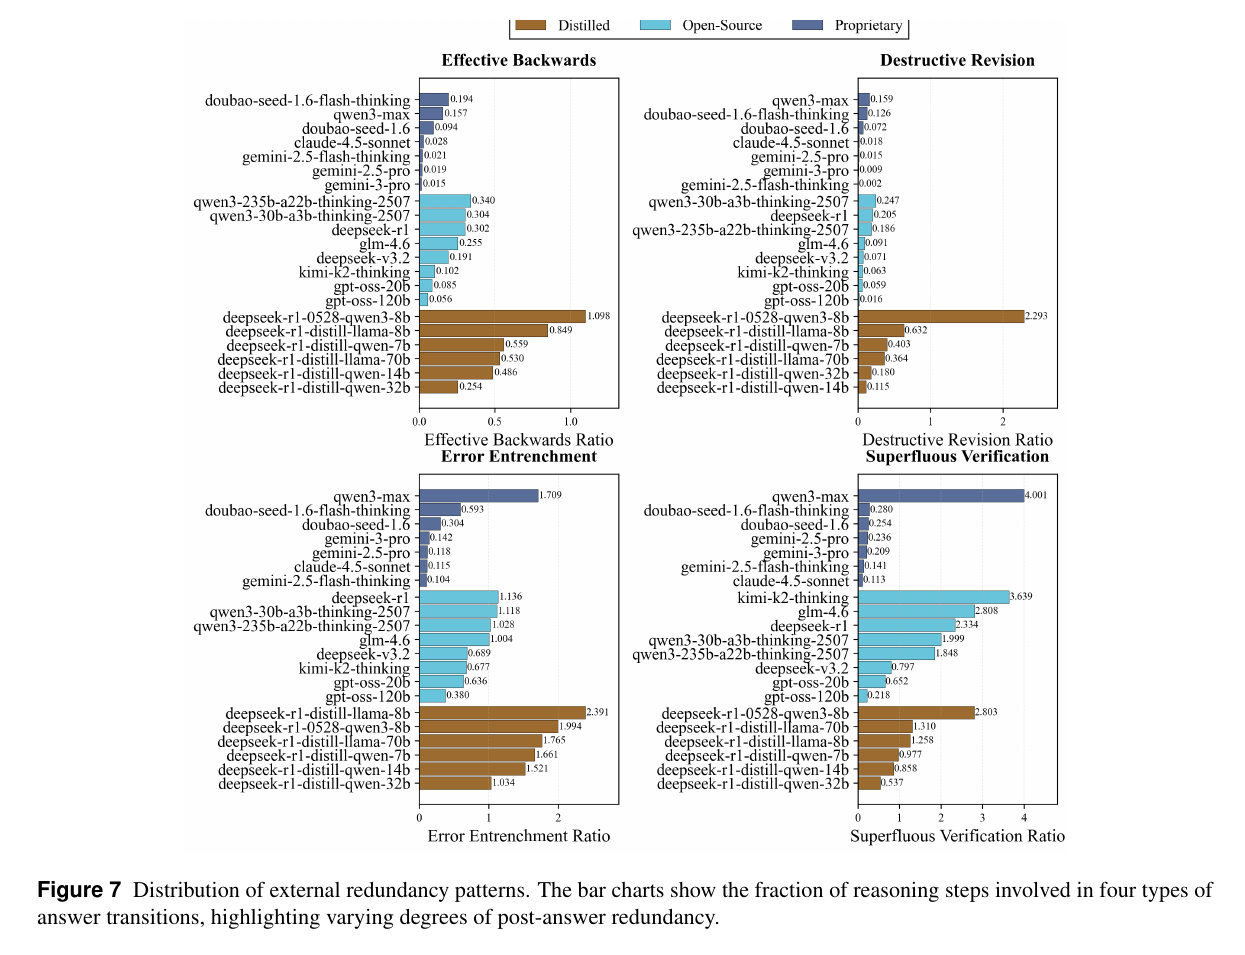
Figure 7 的结论很有启发性:distilled 模型的 DR 往往偏高,说明它们可能学到了“反思的形式”,但没学到稳定修正的能力。某些模型还存在极高的 SV,也就是答案已经正确后仍然大量自我确认,增加延迟却不提升准确率。
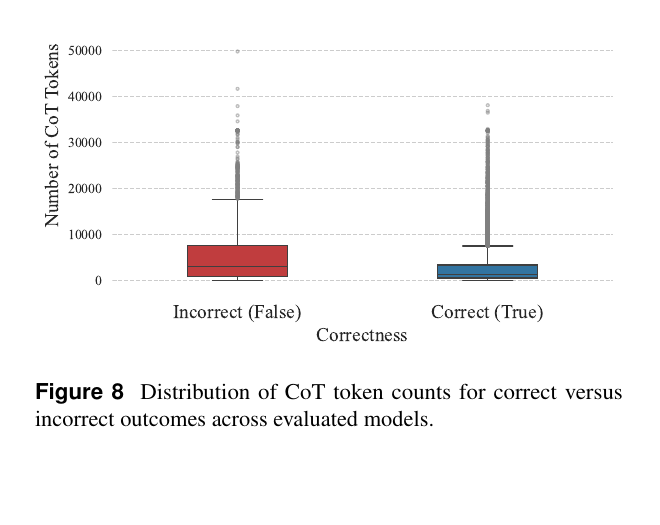
Figure 8 进一步说明:错误回答通常对应更高的 token 中位数和更宽的分布。这意味着模型在推理失败时会生成更多内容试图自救,但这种“越错越长”的行为经常只是低效循环。
6. 我认为这篇论文最有价值的地方
这篇论文的价值不只是提出一个新指标,而是改变了评价 CoT 的角度。
过去我们容易把 CoT 当作一段文本来评价:越详细似乎越好,越短似乎越省。但 CoTJudger 提醒我们,推理更像一个结构过程:有主干、有分支、有回跳、有重复、有错误路径,也有答案后的尾巴。真正重要的是:
模型是否用尽可能少的必要步骤,稳定地到达正确答案?
这对未来的 LRM 训练和评估都有意义。
- 模型评测:不仅看 accuracy,还看 $R$、$\bar{D}$、post-answer redundancy 等结构指标。
- 推理压缩:压缩 CoT 时不能只删 token,而要保护 SEP。
- 奖励建模:可以奖励接近 SEP 的推理,而不是奖励“看起来很努力”的长推理。
- 蒸馏训练:蒸馏不应只模仿 teacher 的长 CoT,否则可能把 teacher 的冗余也学过去。
- 部署成本控制:在生产环境中,低冗余的正确推理比“长篇但答对”更可取。
7. 可能的局限
当然,CoTJudger 也有一些需要继续讨论的地方。
第一,它依赖 GPT-5 做 atomization、classification、answer detection 和 path validation。虽然论文做了模块稳定性验证,但评价器本身仍然有 LLM judge 的偏差问题。
第二,SEP 是“最短有效路径”,但真实推理中有些中间冗余可能有稳定上下文、降低错误率的作用。Figure 3 也说明中段冗余可能不是纯噪声,而是模型维持状态的一种机制。
第三,图构建规则本身会影响 $R$ 和 $\bar{D}$。例如哪些反思可以被 shortcut 跳过,哪些修正必须保留,这些设计都会影响最终冗余判断。
第四,如果未来模型不显式输出 CoT,而是使用隐藏推理,CoTJudger 这种外部文本方法需要调整适用范围。
8. 总结
CoTJudger 的核心思想很清晰:不要只问模型有没有答对,也不要只数它写了多少 token,而要看它的推理路径中有多少是必要的。
它用图结构把 CoT 中的重复、回跳、验证、修正和无效分支显性化,再通过 SEP 给出冗余率:
\[R = \frac{|V| - L_{eff}}{|V|}\]这让“推理效率”从一个模糊感受变成了可比较、可诊断的结构指标。对大模型研究来说,这篇论文有一个很重要的提醒:未来的 reasoning quality 不应该只包含 correctness,也应该包含 structural necessity。换句话说,好的推理不只是把答案说出来,还要尽量少走没必要的弯路。